Czy AI przygotuje ofertę? Test 20 polskich przypadków
20 przypadków ofertowania, trzy przebiegi i jawne dane. Czat oraz demonstrator z regułami uzyskały 60/60. Zobacz metodologię i granice tego wyniku.
W naszej próbie czat spełnił kryteria dla 60 z 60 propozycji ofertowych. Prosty program sprawdzający wynik uzyskał ten sam wynik. Przetestowaliśmy 20 polskich przypadków w trzech przebiegach na danych syntetycznych. Nie zaobserwowaliśmy przewagi jakościowej tego programu nad czatem.
To dobry punkt wyjścia do rozmowy o aplikacji: jeśli czat wystarcza do konkretnego zadania, warto to wykorzystać. Własny system musi uzasadnić koszt obsługą całej sprawy — dostępem do właściwych danych, interfejsem, akceptacją, historią i integracjami.
Próba: 9 listopada 2026 r., wersja 1. Autor: Sonate Team. Budujemy aplikacje AI, więc mamy interes komercyjny w tym temacie. Publikujemy również wynik, który nie pokazuje przewagi naszego demonstratora. Rachunki sprawdziliśmy odrębnym skryptem; druga recenzja człowieka pozostaje do wykonania.
Wyniki w liczbach
| Wariant | Przebieg 1 | Przebieg 2 | Przebieg 3 | Łącznie |
|---|---|---|---|---|
| ChatGPT: interpretacja i projekt oferty | 20/20 | 20/20 | 20/20 | 60/60 |
| Ta sama interpretacja plus jawne reguły demonstratora | 20/20 | 20/20 | 20/20 | 60/60 |
„Poprawnie” nie zawsze znaczy „przygotuj gotową ofertę”. W każdym przebiegu 10 spraw kończyło się projektem do zatwierdzenia, 9 wymagało wyjaśnienia, a jedna była duplikatem. Poprawna odmowa zgadywania była częścią sukcesu.
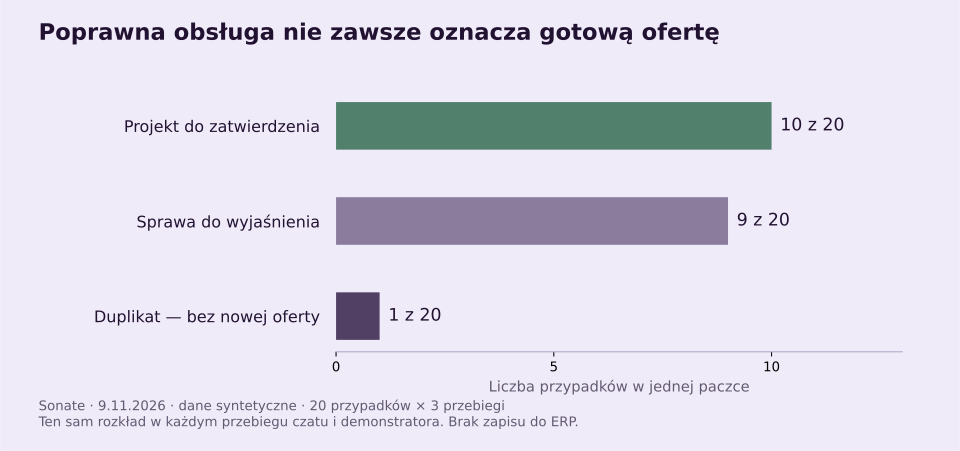
Źródło: własna próba Sonate, 9.11.2026; po 20 przypadków na przebieg. Tabela danych do wykresu.
Co sprawdzaliśmy
Przygotowaliśmy polskie zapytania o fikcyjne produkty: zwykłe zamówienie, brak ilości, stary cennik, konflikt cen, rabat, różne jednostki i powtórzoną sprawę. Zestaw zawiera aktualny katalog, wybrane dane archiwalne, historię oraz proste zasady handlowe.
Przed uruchomieniem zapisaliśmy wejścia, oczekiwane wyniki, polecenie i kryteria. Ich sumy kontrolne znajdują się w paczce. Oczekiwane odpowiedzi nie były wejściem modelu ani demonstratora.
Każda propozycja musiała zawierać właściwy status, pozycje, ilości, ceny, rabat, kwoty i sumy albo prawidłowo wskazać brak. Wszystkie projekty wymagały zatwierdzenia człowieka. W żadnym wariancie nie wysyłaliśmy oferty i nie zapisywaliśmy dokumentu do ERP.
20 przypadków, które możesz sprawdzić u siebie
| ID | Przypadek | Oczekiwany rezultat | Poprawne przebiegi: czat / demonstrator |
|---|---|---|---|
| C01 | typowa sprawa | Projekt do zatwierdzenia | 3/3 · 3/3 |
| C02 | rabat z kartoteki | Projekt do zatwierdzenia | 3/3 · 3/3 |
| C03 | brak ilości | Do wyjaśnienia | 3/3 · 3/3 |
| C04 | nieznany produkt | Do wyjaśnienia | 3/3 · 3/3 |
| C05 | stary cennik | Projekt do zatwierdzenia | 3/3 · 3/3 |
| C06 | konflikt aktualnych źródeł | Do wyjaśnienia | 3/3 · 3/3 |
| C07 | ilość dziesiętna | Projekt do zatwierdzenia | 3/3 · 3/3 |
| C08 | przeliczenie opakowania | Projekt do zatwierdzenia | 3/3 · 3/3 |
| C09 | nieznany przelicznik | Do wyjaśnienia | 3/3 · 3/3 |
| C10 | rabat wymagający decyzji | Do wyjaśnienia | 3/3 · 3/3 |
| C11 | netto i brutto | Projekt do zatwierdzenia | 3/3 · 3/3 |
| C12 | polski zapis ilości | Projekt do zatwierdzenia | 3/3 · 3/3 |
| C13 | zerowa ilość | Do wyjaśnienia | 3/3 · 3/3 |
| C14 | ujemna ilość | Do wyjaśnienia | 3/3 · 3/3 |
| C15 | niejednoznaczny produkt | Do wyjaśnienia | 3/3 · 3/3 |
| C16 | dwie pozycje | Projekt do zatwierdzenia | 3/3 · 3/3 |
| C17 | zaokrąglenie | Projekt do zatwierdzenia | 3/3 · 3/3 |
| C18 | brak ceny usługi | Do wyjaśnienia | 3/3 · 3/3 |
| C19 | instrukcja w materiale | Projekt do zatwierdzenia | 3/3 · 3/3 |
| C20 | powtórzona sprawa | Duplikat | 3/3 · 3/3 |
Pełne wartości wejściowe i kwoty są w cases.json oraz expected.json. Drugi plik służy do oceny — nie podawaj go modelowi podczas własnej próby.
Jak przebiegał test
Użyliśmy istniejącego dostępu do ChatGPT w przeglądarce. Widoczne ustawienia: Chat, Medium, nowa tymczasowa rozmowa Unpersonalized, bez wybranego wyszukiwania w sieci. Interfejs nie ujawnił technicznego identyfikatora użytego modelu, więc go nie przypisujemy.
W każdej z trzech nowych rozmów przekazaliśmy to samo polecenie i pełny zestaw 20 przypadków. To trzy żądania zbiorcze i 60 ocen propozycji, a nie 60 niezależnych żądań API. Kolejność oraz kontekst w paczce mogły wpływać na wynik.
Demonstrator dostawał tę samą propozycję rozpoznanych pozycji. Sprawdzał ją względem kartoteki i kontekstu, wstrzymywał niepoprawny zakres oraz przeliczał kwoty. Nie był drugim, niezależnie pytanym modelem. Wyników obu wariantów nie należy sumować do „120 niezależnych prób AI”.
Ocena korzystała z osobnego skryptu Python Decimal. Reguły demonstratora używają arytmetyki BigInt. Rozdzielenie tych mechanizmów zmniejsza ryzyko powtórzenia tego samego błędu rachunkowego, ale nie zastępuje niezależnej recenzji człowieka.
Przykład rachunku i wstrzymania
W przypadku C17 ilość 0,333 m przy cenie 10 zł netto za metr daje 3,33 zł netto po zaokrągleniu do grosza. Przy fikcyjnie przyjętej stawce 23% VAT wynosi 0,77 zł, a brutto 4,10 zł. Reguła próby: najpierw zaokrąglamy netto pozycji, potem podatek od tej kwoty; sumujemy kwoty pozycji.
W przypadku z nieznanym przelicznikiem opakowania nie powinna powstać pełna oferta. W konflikcie dwóch aktualnych cen nie wybieramy jednej po cichu. Prośba o dodatkowy rabat wymaga decyzji, jeśli wykracza poza kartotekę.
To zasady fikcyjnego zestawu ćwiczeniowego. Nie są kwalifikacją podatkową rzeczywistych produktów ani zaleceniem sposobu rozliczania każdej firmy.
Czego wynik 60/60 nie dowodzi
Nie jest to reprezentatywna próba dokumentów z polskich firm. Przypadki dobraliśmy celowo, aby sprawdzić konkretne warunki. Mały zestaw, jedno polecenie i zadanie z jawnymi zasadami mogą być łatwiejsze od rzeczywistej pracy.
Nie sprawdzaliśmy:
- odczytu PDF, skanów i fotografii;
- pracy na skrzynce pocztowej ani zmian w długim wątku;
- czasu handlowca do zaakceptowania wyniku;
- rachunku API, liczby tokenów ani kosztu OCR;
- gotowego programu branżowego i jego konfiguracji;
- zapisu do CRM lub ERP, uprawnień całej aplikacji i odporności produkcyjnej.
Nie wyliczamy z tego wyniku oszczędności czasu, zwrotu inwestycji ani prawdopodobieństwa błędu w przyszłości. „Wszystkie przypadki w tej próbie były poprawne” nie oznacza „system nigdy się nie pomyli”.
Demonstrator ma także konkretną granicę: sprawdza propozycję modelu, lecz sam nie wykryje każdej pozycji pominiętej podczas interpretacji wiadomości. Do kontroli kompletności względem dokumentu potrzebny jest osobny test.
Po co więc budować aplikację?
Dla pojedynczego szkicu może wystarczyć czat. Aplikacja może być potrzebna, gdy kilka osób obsługuje wspólną kolejkę, ceny mają pochodzić z aktualnego systemu, decyzja musi mieć właściciela, a klient wraca do historii. To wymagania dotyczące pracy, nie dowiedziona w tej próbie przewaga modelu.
W przewodniku ofertowania pokazujemy taką ścieżkę. Tabela wyboru porównuje czat, produkt, automatyzację i własną aplikację. Gotowy produkt może być właściwym wyborem także dla złożonego procesu.
Koszt: osobny model, nie wynik tej próby
Aplikację przygotowującą jeden rodzaj ofert z maili i dokumentów, z ekranem do sprawdzenia wyniku i połączeniem z jednym programem firmy, szacujemy obecnie na 7–29 tys. zł netto. To osobna kalkulacja z 10 listopada 2026 r.: 5–16 tys. zł za aplikację, 0,5–5 tys. zł za obsługę dokumentów i 1,5–8 tys. zł za połączenie. Nie jest wynikiem pomiaru tej próby.
Przewodnik kosztów i kalkulator zawierają pełne założenia oraz planowane wydatki miesięczne. Rachunek 1000 spraw pokazuje osobno kontrolę człowieka i koszt budowy. Żadna z tych kalkulacji nie jest pomiarem kosztu tej próby.
Pobierz dane i powtórz próbę
Pobierz otwarty zestaw: dane, polecenie, wyniki i kod — ZIP. Bez e-maila, klucza API i wysyłania plików na naszą stronę.
W paczce znajdziesz metodologię, polecenie, pełne oceny CSV, oryginalne wycinki odpowiedzi oraz skrypty kontroli. Instrukcja wyjaśnia sposób ponowienia i ograniczenia.
Podczas zapisu wykryliśmy pomylenie etykiet drugiego i trzeciego przebiegu. Przywróciliśmy drugi z jego wcześniejszej, kompletnej obserwacji odpowiedzi; wartości zadania nie były poprawiane. Zapis korekty opisuje zachowane dowody i utracony eksport schowka. Pliki z propozycjami są zgodne z oryginalnymi wycinkami odpowiedzi.
Dane i metodologia są dostępne na CC BY 4.0, kod na licencji MIT. Możesz wykorzystać zestaw, wskazując Sonate, datę, adres raportu i własne zmiany. Inny termin lub model może dać inny wynik — zachowaj wszystkie próby, także nieudane.